从 VLM、VLA 到具身智能,AI 正在从“理解信息”走向“理解世界”
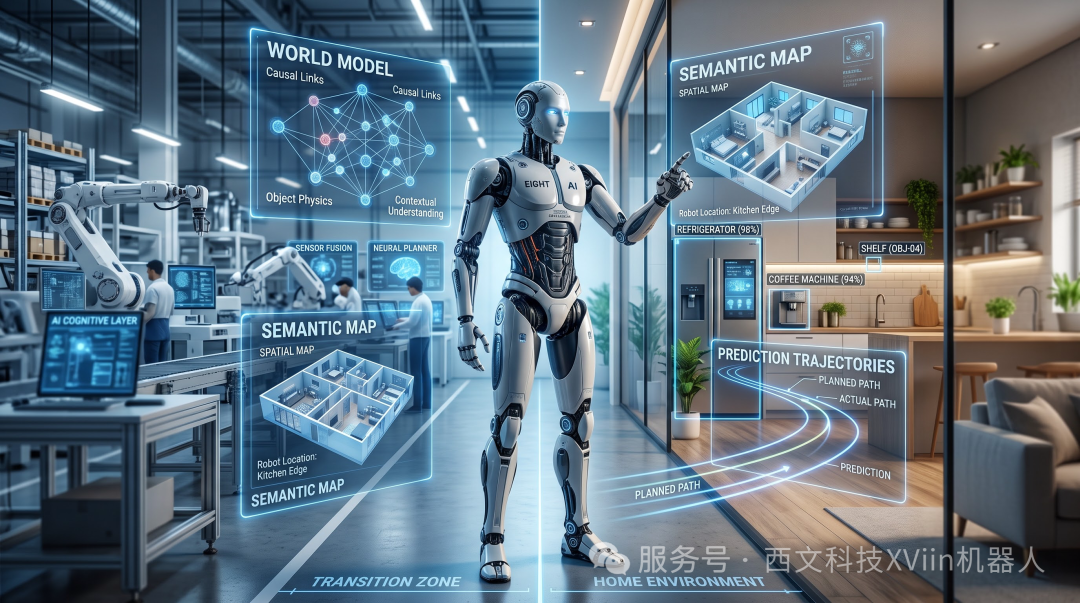
从大语言模型理解文字,到视觉模型识别图像,再到能够控制机器人完成任务,AI正在逐渐突破数字世界的边界。人看到一只杯子,不仅知道它是“杯子”,还会自然判断它的位置、形状、重量以及是否容易打碎。如果杯子放在桌边,我们甚至可以预测:稍微碰一下,它可能就会掉下来。这种对空间、物体、变化、因果和未来状态的理解,是人类智能的重要组成部分。而让机器拥有类似能力,正是世界模型(World Model)试图解决的问题。
一、世界模型到底是什么?
世界模型,是AI在内部建立的一套关于现实世界运行规律的模型。它不只是告诉AI“眼前有什么”,还需要进一步理解:“这里有一个苹果。”
苹果位于桌面上,距离机械臂一定距离;机器人需要避开桌面上的其他物体;如果机械臂移动到苹果的位置,就可以尝试抓取它。
从“识别一个物体”,到“理解物体与环境之间的关系”,这就是世界模型所关注的问题
二、从 VLM 到 VLA:AI正在获得“眼睛”和“手”
VLM,即视觉语言模型(Vision-Language Model)。“图中有几个人?”
“桌子上的物体是什么?”
“这个场景发生了什么?”
而VLA,即视觉-语言-动作模型(Vision-Language-Action Model),进一步将视觉、语言与机器人动作连接起来。“把桌上的杯子拿到厨房。”
看到杯子 → 理解指令 → 定位杯子 → 规划动作 → 控制机械臂 → 完成抓取。
三、世界模型最重要的能力:预测
世界模型与普通AI系统最大的区别之一,就是预测未来状态。如果机械臂向左移动,会发生什么?
如果抓取位置偏移,会发生什么?
如果施加的力量过大,会发生什么?
如果前方突然出现障碍物,应该怎么办?
这种能力可以理解为AI在内部进行一次“未来模拟”。比如我们拿起一个装满水的杯子时,会自然控制力度和速度。
四、为什么世界模型对具身智能如此重要?
如果说大语言模型主要存在于数字世界,那么具身智能需要真正进入物理世界。机器人面对的不是一段文字,而是一个不断变化的真实环境。“这是一个杯子。”
“这是一个易碎物体。”
“如果抓取力度过大,杯子可能破碎。”
“调整机械臂位置,以合适的力度完成抓取。”
感知 → 理解 → 预测 → 决策 → 行动 → 反馈
五、世界模型像是机器人的“内部模拟器”
如果现实环境发生变化,机器人又可以根据新的视觉和传感器信息重新计算。因此,真正成熟的具身智能,并不是简单地执行固定程序。理解环境 → 预测变化 → 制定计划 → 执行动作 → 根据反馈不断调整。
六、世界模型距离成熟还有多远?
三维空间、连续时间、复杂物理规律、不确定性以及大量突发情况。实验室里的机器人可以完成标准化任务,但当它进入家庭、工厂、商场等复杂环境后,问题会迅速增加。空间理解能力、物理理解能力、长期记忆能力、因果推理能力、未来预测能力以及实时适应能力。这也是当前人工智能与机器人产业持续探索的重要方向。
七、从“会说”到“会做”,AI正在进入下一阶段
如果回顾人工智能的发展,可以看到一条越来越清晰的路径:大语言模型 → 视觉语言模型 → 视觉-语言-动作模型 → 世界模型 → 具身智能最终,它需要理解现实世界的运行规律,并能够在这个世界中持续行动。AI的竞争正在从“谁拥有更多知识”,逐渐走向“谁能够更好地理解和改变现实世界”。未来的人工智能,可能不再只是电脑或手机里的一个对话窗口。它可能拥有身体、传感器和执行机构,进入工厂、家庭、商业空间以及更多真实场景。而世界模型,有可能成为连接数字智能与物理世界的重要桥梁。
结语
让机器预测世界,并在世界中采取行动,才可能真正走向具身智能。而当模型、算法、机器人本体与真实场景进一步融合,AI也将从屏幕里的数字智能,逐渐走向现实世界中的具身智能。未来,AI不仅会回答我们的问题,也可能真正走进我们的生活。