它到底是什么?一句话:VLA是让机器人“看得见、听得懂、动得了”的大模型。
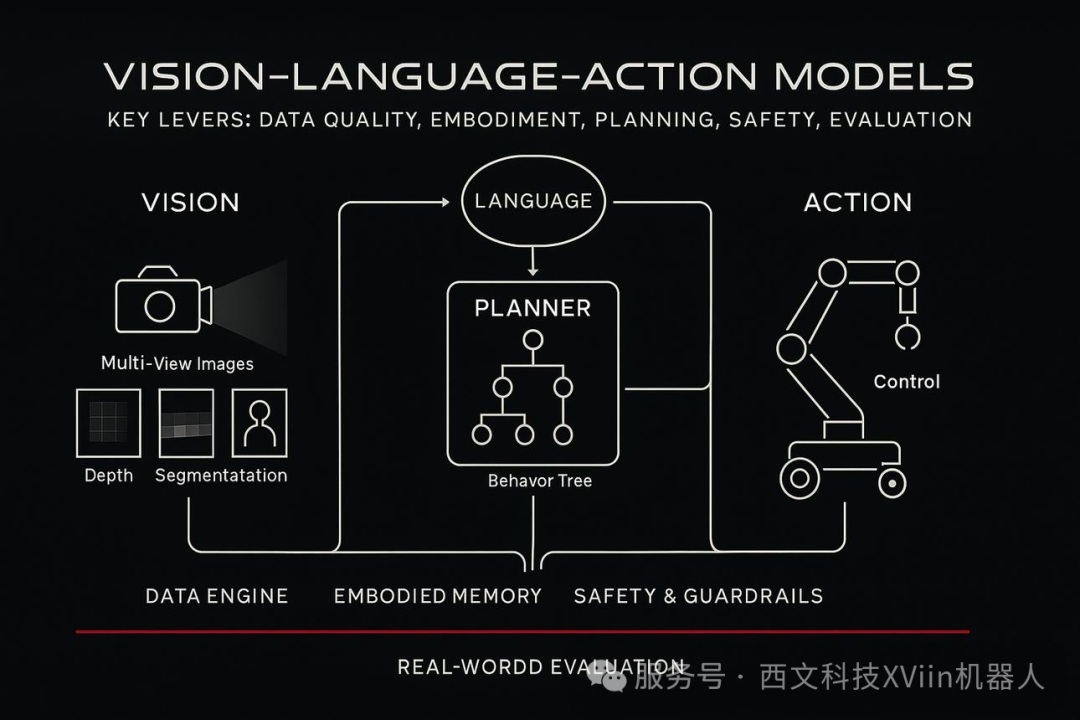
VLA全称 Vision-Language-Action Model,中文叫“视觉-语言-动作模型”。它把三种能力装进同一个AI系统:视觉负责看懂世界,语言负责理解指令,动作负责控制机器人执行。比如你说“把桌上红色杯子拿给我”,它不只是听懂这句话,还要看懂哪个是杯子、红色在哪、机械臂该怎么伸、夹爪何时闭合。
我们熟悉的LLM,比如聊天机器人,是输入文字、输出文字。
VLM,视觉语言模型,是输入图片加文字、输出文字,擅长“看图说话”。
而VLA,输入的是图像、语言和机器人状态,输出的是动作。
所以可以简单类比:
LLM:文字进,文字出;
VLM:图+文进,文字出;
VLA:图+文+状态进,动作出。
VLA相当于在VLM基础上,加了一个“动作解码头”。它不只会理解世界,还要改变世界。
典型流程是:摄像头采集画面,人类下达语言指令,模型结合视觉、语言和机器人当前状态,直接输出动作序列,比如移动、抓取、旋转、放置。机器人执行后,摄像头再看到新画面,模型继续调整,形成闭环。
这和传统机器人很不一样。传统机器人通常拆成感知、语言理解、任务规划、运动控制多个模块,每个环节分别开发。VLA追求的是端到端:一个模型,从看到、听懂,到直接输出动作。
因为它被视为具身智能的关键方向。过去机器人擅长在固定环境里重复动作,一到开放世界就容易失灵。VLA希望借助大模型的泛化能力,让机器人像人一样适应新物体、新指令、新环境。
这也是为什么大厂和资本都在押注。Google有RT-1、RT-2,开源社区有OpenVLA,Physical Intelligence推出π0,Figure做人形机器人VLA,NVIDIA发布GR00T N1。大家争的,是机器人从“专用自动化设备”变成“通用智能体”的入口。
它可能重塑机器人产业链。上游是算力、芯片、传感器;中游是模型、数据、仿真平台;下游是制造、物流、家庭服务、医疗康复等场景。谁掌握高质量机器人数据,谁就可能建立新的护城河。因为互联网文本和图像数据很多,但机器人动作数据极其稀缺。
对投资者来说,VLA不是单一公司概念,而是一条链:算力、数据、硬件、场景,缺一不可。对学生和科技爱好者来说,它融合了多模态大模型、机器人学习、控制理论,是AI下一个前沿交叉方向。
但难点也很明显
第一,数据稀缺。机器人动作数据远少于互联网文本。
第二,实时性。大模型推理慢,机器人控制却要求毫秒级响应。
第三,安全性。动作错了可能撞坏东西,甚至伤人。
第四,泛化难。实验室能跑,真实世界复杂多变。
第五,成本高。训练和部署都需要大量算力与硬件。
所以,VLA很热,但距离真正通用、可靠、便宜的机器人,还有很长的路。