في السنوات القليلة الماضية، كان معدل تطور الذكاء الاصطناعي مذهلاً.من فهم النصوص عبر نماذج اللغة الكبيرة، إلى التعرف على الصور بواسطة النماذج البصرية، وصولًا إلى القدرة على توجيه الروبوتات لإنجاز المهام، يواصل الذكاء الاصطناعي تجاوز حدود العالم الرقمي تدريجيًا.ولكن لا تزال هناك مشكلة رئيسية:هل منظمة العفو الدولية حقا "يفهم" العالم ؟عندما يرى الناس فنجان ، لا يعرفون فقط أنه "كوب" ، ولكن أيضًا يحكم بشكل طبيعي على موقعه وشكله ووزنه وما إذا كان من السهل كسره.إذا تم وضع الكوب على الطاولة ، فيمكننا حتى التنبؤ: إذا لمسه قليلاً ، فقد يسقط.هذا صحيحالفضاء ، الأجسام ، التغيرات ، السببية والحالة المستقبليةفهم جزء مهم من الذكاء البشري.إن ترك الجهاز يتمتع بقدرات مماثلة هو بالضبط المشكلة التي يحاول نموذج العالم حلها.
1. ما هو بالضبط نموذج العالم ؟
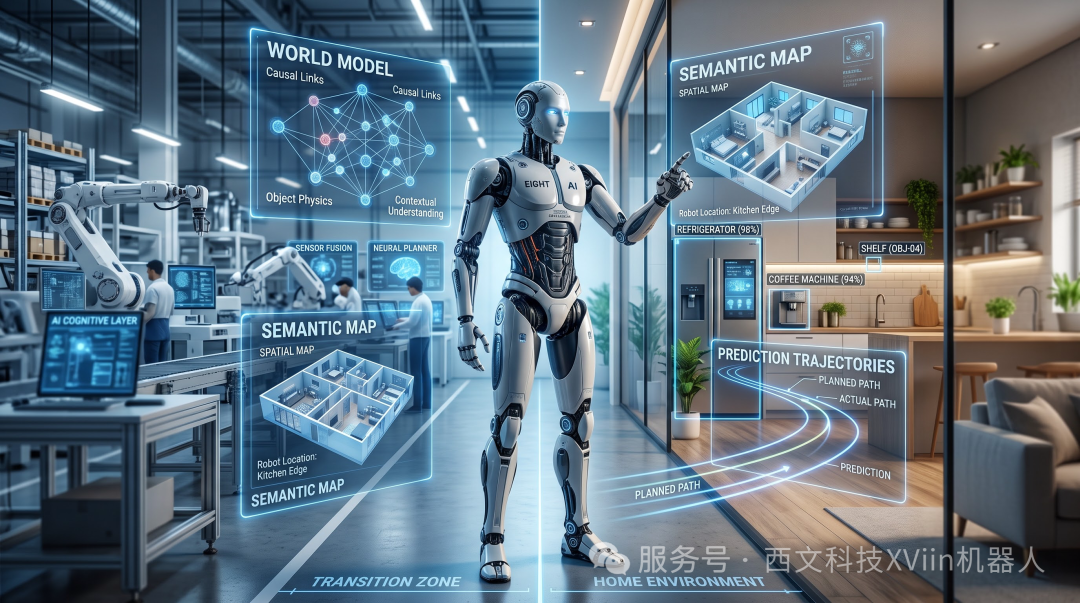
نموذج العالم هو مجموعة من النماذج التي أنشأتها منظمة العفو الدولية داخليًا حول قوانين تشغيل العالم الحقيقي.لا يتعلق الأمر فقط بإخبار منظمة العفو الدولية "ما هو في متناول اليد" ، بل يحتاج إلى مزيد من الفهم:ما هي العلاقة بين الأشياء ؟ما الذي يتغير في البيئة ؟ماذا يمكن أن يحدث بعد ذلك ؟ما هي النتيجة إذا تم اتخاذ إجراء معين ؟على سبيل المثال ، يرى الروبوت تفاحة على الطاولة.قد يخبر نظام الرؤية العادي الروبوت:"هناك تفاحة هنا."
يحتاج الذكاء الاصطناعي ، الذي يتمتع بقدرات النموذج العالمي ، إلى مزيد من الفهم:تقع Apple على سطح المكتب ، على مسافة معينة من الذراع الروبوتية ؛ يحتاج الروبوت إلى تجنب الأشياء الأخرى على سطح المكتب ؛ إذا انتقلت الذراع الآلية إلى موضع Apple ، يمكنك محاولة الاستيلاء عليها.
من "تحديد كائن" ، إلى "فهم العلاقة بين الكائن والبيئة" ، هذا ما يثير قلق نموذج العالم
2. من VLM إلى VLA: تكتسب منظمة العفو الدولية "العيون" و "الأيدي"
لفهم النموذج العالمي ، يمكنك أولاً فهم مفهومين مهمين:VLM ، الذي هونموذج لغة الرؤية (Vision-Language Model)。إنه يتيح لمنظمة العفو الدولية التعامل مع المعلومات المرئية واللغوية في نفس الوقت."كم عدد الأشخاص في الصورة ؟"
"ما هي الأشياء على الطاولة ؟"
"ماذا حدث لهذا المشهد ؟"
و VLA ، أيالرؤية-اللغة-نموذج العمل (Vision-Language-Action Model)، قم بتوصيل الرؤية واللغة بحركات الروبوت."خذ الكأس على الطاولة إلى المطبخ."
رؤية الكأس ← فهم التعليمات ← تحديد موقع الكأس ← التخطيط للعمل ← التحكم في الذراع الروبوتية ← إكمال الاستيلاء.لذلك يمكن فهمه ببساطة على النحو التالي:VLA: العمل على أساس التفاهمفي حين أن النموذج العالمي يحاول حل أكثر:
三、世界模型最重要的能力:预测
世界模型与普通AI系统最大的区别之一,就是预测未来状态。如果机械臂向左移动,会发生什么?
如果抓取位置偏移,会发生什么?
如果施加的力量过大,会发生什么?
如果前方突然出现障碍物,应该怎么办?
这种能力可以理解为AI在内部进行一次“未来模拟”。比如我们拿起一个装满水的杯子时,会自然控制力度和速度。
四、为什么世界模型对具身智能如此重要?
如果说大语言模型主要存在于数字世界,那么具身智能需要真正进入物理世界。机器人面对的不是一段文字,而是一个不断变化的真实环境。“这是一个杯子。”
“这是一个易碎物体。”
“如果抓取力度过大,杯子可能破碎。”
“调整机械臂位置,以合适的力度完成抓取。”
感知 → 理解 → 预测 → 决策 → 行动 → 反馈
五、世界模型像是机器人的“内部模拟器”
如果现实环境发生变化,机器人又可以根据新的视觉和传感器信息重新计算。因此,真正成熟的具身智能,并不是简单地执行固定程序。理解环境 → 预测变化 → 制定计划 → 执行动作 → 根据反馈不断调整。
六、世界模型距离成熟还有多远?
三维空间、连续时间、复杂物理规律、不确定性以及大量突发情况。实验室里的机器人可以完成标准化任务,但当它进入家庭、工厂、商场等复杂环境后,问题会迅速增加。空间理解能力、物理理解能力、长期记忆能力、因果推理能力、未来预测能力以及实时适应能力。这也是当前人工智能与机器人产业持续探索的重要方向。
七、从“会说”到“会做”,AI正在进入下一阶段
如果回顾人工智能的发展,可以看到一条越来越清晰的路径:大语言模型 → 视觉语言模型 → 视觉-语言-动作模型 → 世界模型 → 具身智能最终,它需要理解现实世界的运行规律,并能够在这个世界中持续行动。AI的竞争正在从“谁拥有更多知识”,逐渐走向“谁能够更好地理解和改变现实世界”。未来的人工智能,可能不再只是电脑或手机里的一个对话窗口。它可能拥有身体、传感器和执行机构,进入工厂、家庭、商业空间以及更多真实场景。而世界模型,有可能成为连接数字智能与物理世界的重要桥梁。
结语
让机器预测世界,并在世界中采取行动,才可能真正走向具身智能。而当模型、算法、机器人本体与真实场景进一步融合,AI也将从屏幕里的数字智能,逐渐走向现实世界中的具身智能。未来,AI不仅会回答我们的问题,也可能真正走进我们的生活。