ما هو بالضبط؟ جملة واحدة:VLA هو نموذج كبير يجعل الروبوت "يرى ويفهم ويتحرك".
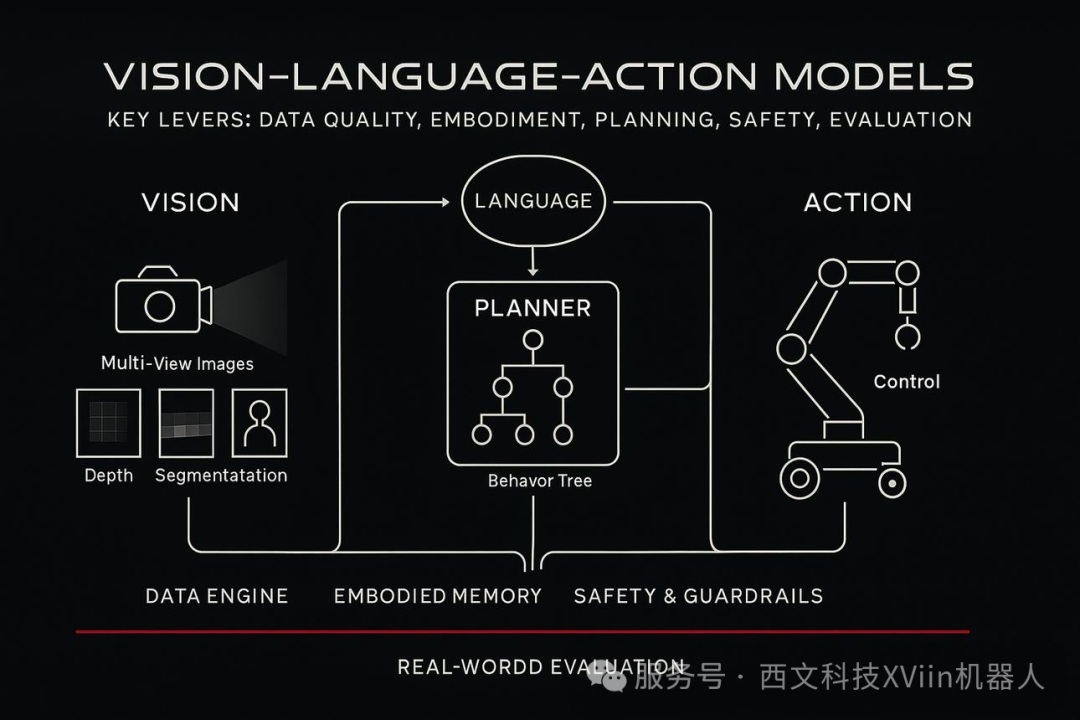
الاسم الكامل لـ VLA هو Vision-Language-Action Model ، ويسمى "Vision-Language-Action Model" باللغة الصينية. إنه يضع ثلاث قدرات في نفس نظام الذكاء الاصطناعي: الرؤية مسؤولة عن فهم العالم ، واللغة مسؤولة عن فهم التعليمات ، والعمل مسؤول عن التحكم في تنفيذ الروبوت. على سبيل المثال ، إذا قلت "أعطني الكوب الأحمر على الطاولة" ، فهو لا يفهم هذه الجملة فحسب ، بل يفهم أيضًا الكأس ، وأين الأحمر ، وكيفية تمديد الذراع الآلية ، ومتى يتم إغلاق المخالب.
LLM الذي نعرفه ، مثل روبوت الدردشة ، هو إدخال النص وإخراج النص.
VLM ، نموذج اللغة المرئية ، هو إدخال الصور بالإضافة إلى النص وإخراج النص ، وهو جيد في "النظر إلى الصور والتحدث".
في VLA ، يتم إدخال الصور واللغة وحالة الروبوت ، والمخرجات هيالعمل。
لذلك يمكن تشبيه بسيط:
LLM: إدخال النص ، إخراج النص ؛
VLM: إدخال الرسومات والنصوص ؛
VLA: يتم إدخال الرسومات والنصوص.
VLA يعادل إضافة "محطة حل الحركة" على أساس VLM. لن يفهم العالم فحسب ، بل سيغير العالم أيضًا.
العملية النموذجية هي: تجمع الكاميرا الصورة ، ويصدر البشر تعليمات اللغة ، ويجمع النموذج بين الرؤية واللغة والحالة الحالية للروبوت لإخراج تسلسل العمل مباشرة ، مثل الحركة والاستيلاء والدوران ووضع. بعد تنفيذ الروبوت ، ترى الكاميرا الصورة الجديدة مرة أخرى ، ويستمر النموذج في الضبط لتشكيل حلقة مغلقة.
هذا مختلف تمامًا عن الروبوتات التقليدية. عادة ما يتم تقسيم الروبوتات التقليدية إلى وحدات متعددة من الإدراك وفهم اللغة وتخطيط المهام والتحكم في الحركة ، ويتم تطوير كل رابط بشكل منفصل. ما يسعى إليه VLA هومن النهاية إلى النهاية: نموذج ، من رؤية وفهم ، إلى عمل الإخراج المباشر.
لأنه يعتبرذكيالاتجاه الرئيسي. في الماضي ، كانت الروبوتات جيدة في تكرار الحركات في بيئة ثابتة ، وكانت عرضة للفشل بمجرد الوصول إلى العالم المفتوح. تأمل VLA في استخدام قدرة التعميم للنماذج الكبيرة للسماح للروبوتات بالتكيف مع الكائنات الجديدة والتعليمات الجديدة والبيئات الجديدة مثل البشر.
هذا هو السبب في أن المصانع الكبيرة ورأس المال يراهنان. تمتلك Google RT-1 و RT-2 و OpenVLA في مجتمع المصادر المفتوحة ، وقد أطلقت Physical Intelligence π 0 ، و Figure هي روبوت بشري VLA ، وأصدرت NVIDIA GR00T N1. ما ينافس عليه الجميع هو مدخل الروبوتات من "معدات أتمتة خاصة" إلى "ذكاء عالمي".
قد يعيد تشكيل سلسلة صناعة الروبوتات. المنبع هو القوة الحسابية ، والرقائق ، وأجهزة الاستشعار ؛ والمصب هو النموذج ، والبيانات ، ومنصة المحاكاة ؛ والمصب هو التصنيع ، والخدمات اللوجستية ، والخدمات المنزلية ، وإعادة التأهيل الطبي وغيرها من المشاهد. من لديه بيانات روبوتية عالية الجودة يمكنه بناء خندق جديد. لأن الإنترنت يحتوي على الكثير من بيانات النص والصور ، ولكن بيانات عمل الروبوت نادرة للغاية.
بالنسبة للمستثمرين ، فإن VLA ليس مفهومًا لشركة واحدة ، ولكنه سلسلة: قوة الحوسبة ، والبيانات ، والأجهزة ، والمشاهد ، لا غنى عنها. بالنسبة للطلاب وعشاق التكنولوجيا ، فإنه يدمج النماذج الكبيرة متعددة الوسائط ، وتعلم الروبوت ، ونظرية التحكم ، وهو الاتجاه المتقاطع التالي لمنظمة العفو الدولية.
لكن الصعوبة واضحة
أولاً ، ندرة البيانات. بيانات عمل الروبوت أقل بكثير من نص الإنترنت.
ثانياً ، في الوقت الحقيقي. النماذج الكبيرة بطيئة في التفكير ، لكن التحكم في الروبوت يتطلب استجابة ميلي ثانية.
ثالثا ، الأمن. قد يؤدي الإجراء الخاطئ إلى إضرار الأشياء أو حتى إيذاء الناس.
رابعًا ، من الصعب التعميم. يمكن تشغيل المختبر ، والعالم الحقيقي معقد وقابل للتغيير.
خامسا ، التكلفة العالية. يتطلب التدريب والنشر الكثير من القوة والمعدات.
لذلك ، فإن VLA حار جدًا ، ولكن لا يزال هناك طريق طويل لنقطعه من روبوتات عالمية وموثوقة ورخيصة حقًا.